
La plupart des outils de synthèse vocale traitent un document comme une longue chaîne de mots. Chaque phrase tombe avec la même intonation plate, les abréviations sont déformées, et une nouvelle section s’enchaîne directement avec la précédente — sans pause, sans signal que quelque chose a changé. Après une demi-heure de cela, vous êtes plus fatigué que si vous aviez simplement lu le texte. L’intérêt de l’audio est de libérer vos yeux, mais vous finissez quand même par jeter un œil à l’écran pour ne pas perdre le fil.
Le problème est pire aux frontières structurelles — titres et listes. Un moteur TTS classique n’a aucune idée qu’un titre est un titre. Il continue tout droit, si bien que « Section 3 : Évaluation des risques » sonne exactement comme la phrase précédente. Les listes ne s’en sortent pas mieux : la voix enchaîne chaque élément sans le temps naturel qu’un lecteur humain placerait avant de passer au suivant.
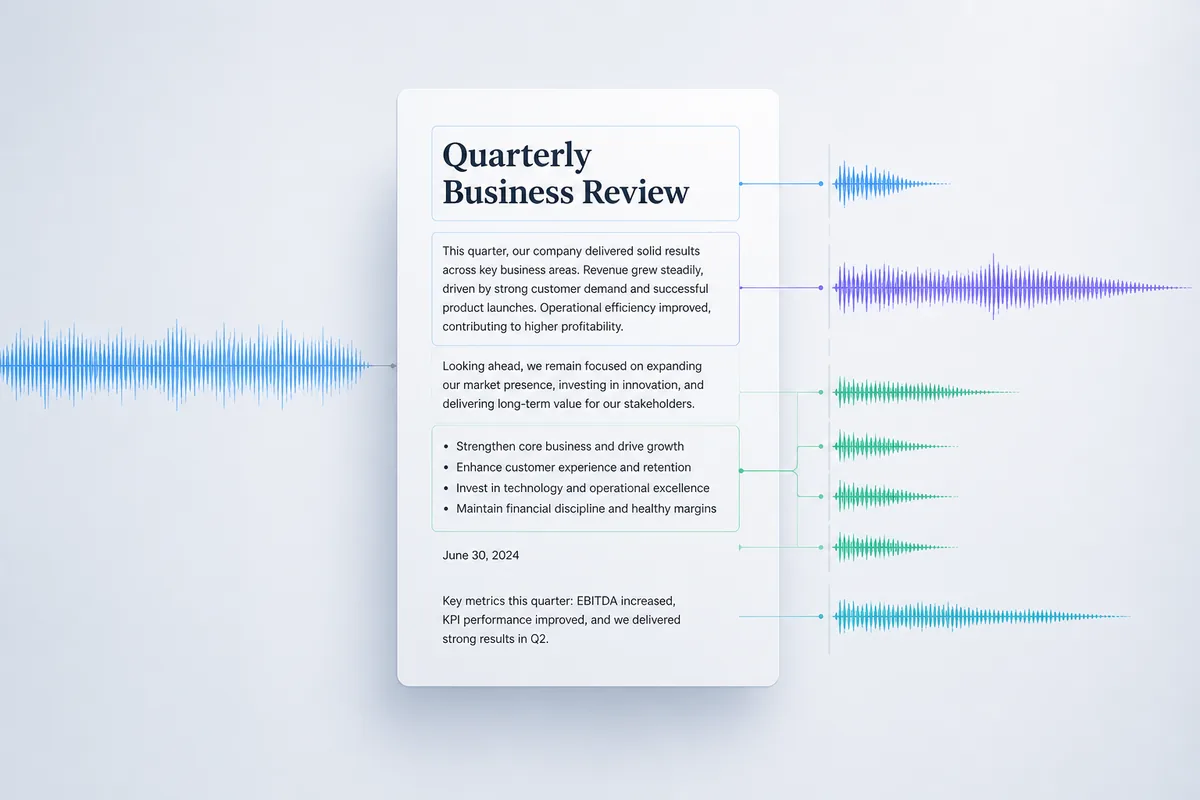
SonikaAI aborde autrement la lecture structurée de documents. Avant le début de la synthèse, le service analyse la structure du document — en identifiant les titres, les entrées de liste, les fins de phrase et les abréviations à développer. Ce contexte façonne ensuite la narration : les pauses tombent là où un humain les placerait, l’intonation change au début d’une nouvelle section, et les dates ou unités de mesure sont lues comme vous les diriez naturellement, plutôt que chiffre par chiffre. Le résultat n’est pas un flux monotone — c’est un audio aux frontières claires entre blocs sémantiques, plus proche d’un narrateur qui lit à voix haute que d’une machine qui lit du texte.
En pratique, la différence se remarque immédiatement. Les titres sonnent comme des titres — une courte pause les précède et un léger changement de ton signale « nouveau sujet ». Un deux-points avant une liste produit le même temps qu’un orateur utiliserait pour introduire des éléments. Les abréviations qui seraient normalement lues lettre par lettre sont traitées de façon sensée selon le contexte. Ce n’est ni un comédien de doublage ni un annonceur en direct, et il vaut la peine de vérifier le résultat sur votre propre matériel — surtout si votre document est riche en termes spécialisés ou en noms propres. Mais pour les rapports, manuels et longs articles, le gain par rapport aux documents en synthèse vocale plats est substantiel. La voix de narration s’adapte aussi automatiquement à la langue de sortie, sans accent étranger, quelle que soit celle des 13 langues prises en charge dans laquelle vous travaillez.
La tarification de la narration de documents repose sur la durée audio plutôt que sur le nombre de pages — les chiffres exacts figurent sur la page de tarifs SonikaAI. Une première étape raisonnable consiste à traiter une courte section — un chapitre ou quelques pages — pour entendre comment votre matériel sonne avant d’engager le document entier. Par défaut, SonikaAI ne traite gratuitement que la portion d’ouverture d’un fichier, exactement ce type d’aperçu à faible risque. Si le résultat vous convient, lancer le reste est simple. Le traitement s’exécute en arrière-plan, vous n’avez donc pas besoin de garder un onglet ouvert pendant qu’il se termine.
Ce type de TTS au son naturel est utile pour quiconque écoute régulièrement des documents de travail dans les transports ou en marchant — un consultant qui digère une pile de rapports, un chercheur qui écoute des articles loin d’un bureau, ou un éditeur qui relit un long brouillon sans rester collé à l’écran. Si la monotonie mécanique vous lasse et que vous voulez entendre ce que donne une narration consciente de la structure sur vos propres fichiers, créez un compte gratuit et essayez votre premier document — aucune carte requise. Pour en savoir plus sur le choix de la voix selon les langues, consultez comment choisir la bonne voix pour la narration de documents.